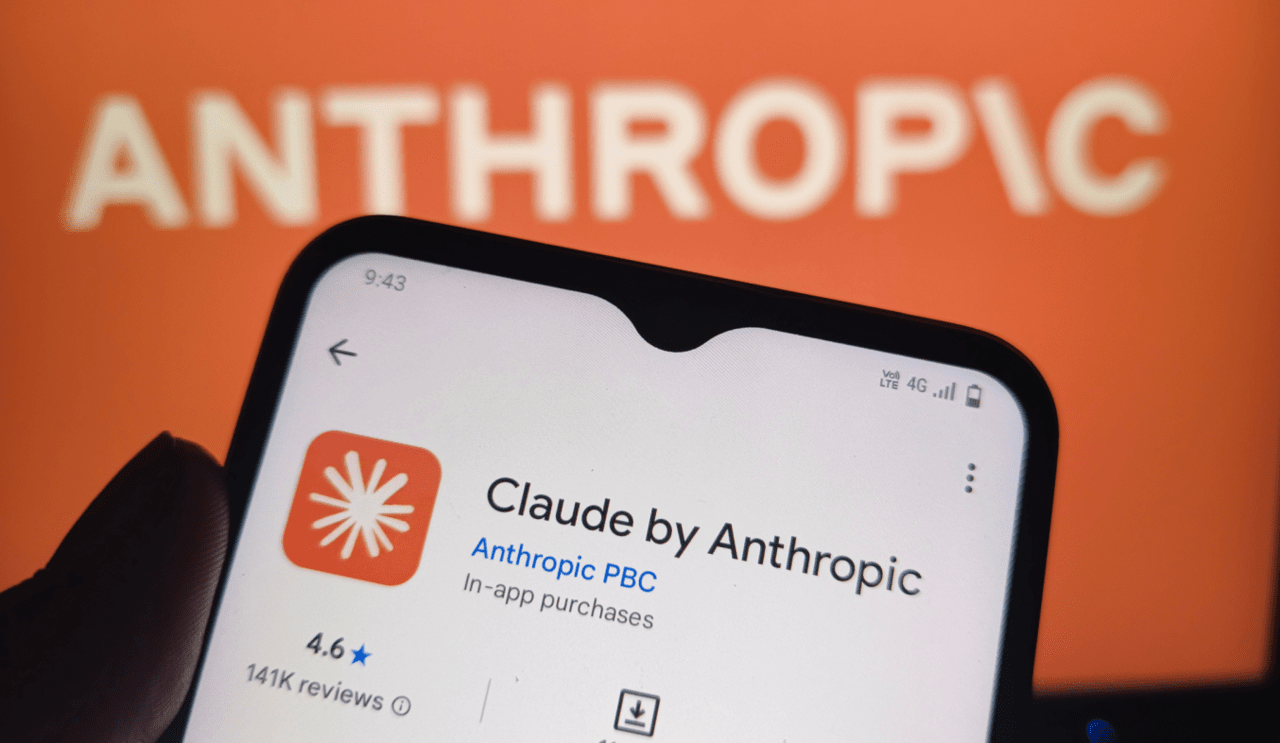
앤트로픽이 '클로드'가 이용자와 나눈 대화의 위험성을 스스로 평가하는 기술을 개발해 실제 서비스에 적용했다. 별도의 AI 모델을 동원하지 않고 클로드가 답변 직후 대화를 검토해 악용 가능성을 판단하는 방식이다. 기존 감시 체계가 놓친 대규모 사기와 불법적인 AI 모델 정보 추출 시도까지 찾아냈으며, 추가 연산 비용도 2% 미만으로 억제했다.
앤트로픽은 최근 공식 연구 블로그를 통해 '자기 평가(Self-Assessment)'라는 새로운 안전 감시 기술의 개발 및 운영 결과를 공개했다. 이 기술은 지난 6월 출시된 '클로드 페이블 5'부터 도입됐으며, 현재 전 세계 클로드 이용량의 상당 부분에 적용되고 있다.
기존에는 이용자의 요청이 위험한지 확인하기 위해 별도의 AI 분류 모델을 운영하거나 특정 유형의 유해 요청을 감지하는 시스템을 사용했다. 그러나 AI를 악용하는 방식이 갈수록 복잡해지면서 미리 정해놓은 규칙으로는 새로운 공격을 찾아내기 어려워졌다. 별도의 고성능 AI 모델로 모든 대화를 검사하려면 막대한 연산 비용도 발생한다.
앤트로픽은 이를 해결하기 위해 클로드가 답변을 마친 직후 자신의 대화를 다시 평가하도록 했다. 이용자의 요청이 유해할 가능성이 있는지, 어떤 유형의 위험인지, 인간 검토자가 얼마나 긴급하게 확인해야 하는지 등을 판단하고 간단한 설명을 생성한다. 이 결과는 별도의 감시 시스템으로 전달되며 이용자에게는 표시되지 않는다.
핵심은 클로드가 이미 대화를 처리하면서 확보한 정보를 그대로 활용한다는 점이다. 별도 모델이 전체 대화를 다시 읽을 필요가 없어 평균적으로 약 10개의 토큰만 추가 생성하면 된다. 앤트로픽은 이에 따른 추가 연산 비용이 전체 추론 비용의 2% 미만이라고 밝혔다.
실제 서비스에서 수집한 대화를 이용한 자체 평가에서는 페이블 5가 기존의 고성능 분류 모델이 유해하다고 판단한 대화의 78%를 찾아냈다. 위험도가 높은 대화에 대한 탐지율은 94%였으며, 정상적인 대화를 잘못 분류하는 비율은 1%였다. 다만 이는 인간 전문가가 확인한 실제 악용 사례의 탐지율이 아니라 별도의 AI 분류 모델을 기준으로 측정한 결과다.
이번 기술의 특징은 사전에 학습하지 않은 유형의 위험도 찾아낼 수 있다는 점이다. 앤트로픽은 사기와 사이버 공격 관련 학습 데이터를 제외하고 실험했지만, 해당 유형의 유해 요청을 탐지하는 성능이 크게 떨어지지 않았다고 설명했다. AI가 개별 공격 패턴을 암기하는 대신 대화의 맥락과 위험성을 판단하는 능력을 활용한다는 것이다.
실제 운영에서도 기존 시스템이 포착하지 못했던 사례가 발견됐다. 지난 8월에는 단일 API 고객 계정에서 아동 성착취 관련 의심 활동을 10만건 이상 감지해 관련 기관에 신고했다. 9월에는 클로드 코드를 이용해 수십 명을 대상으로 연애 사기를 자동화한 조직을 찾아내 계정을 차단했다.
이 밖에도 클로드의 비공개 추론 정보를 빼내려는 불법적인 모델 증류 시도와 프롬프트 인젝션 공격, AI 에이전트가 이용자의 승인 없이 행동한 사례 등이 포착됐다. 자기 평가 기술이 찾아낸 의심 활동 중 기존 분류 체계에 명확하게 속하지 않는 사례도 약 3분의 1에 달했다.
We’ve trained Claude to flag potential misuse in conversations, a technique we call self-assessment. Right after it responds, Claude gives a preliminary safety assessment of the conversation.
Since we began using self-assessment in June, it has surfaced misuse that our other…
— Anthropic (@AnthropicAI) October 29, 2026
이번 연구는 최근 AI를 활용한 사이버 공격이 증가하는 상황과도 연결된다. 또 AI가 코딩과 추론, 장시간 자율 작업에 능숙해질수록 공격자가 AI에 맡길 수 있는 작업도 많아지고 있다. 이에 따라 기존처럼 특정 유해 요청을 차단하는 방식만으로는 복잡한 공격 과정을 파악하기 어렵다는 것이 앤트로픽의 판단이다.
다만 자기 평가 기술이 AI의 악용을 완전히 차단하는 것은 아니다. 앤트로픽은 실제 서비스에서 이 기술을 사후 감시용으로 사용하며, 위험한 요청을 실시간으로 차단하는 기존 안전장치와 함께 운영한다고 설명했다. 별도 실험에서 자기 평가만으로 공격을 차단했을 때 공격 성공률은 79%에서 54%로 낮아지는 데 그쳤다.
클로드가 자신의 행동을 평가한다는 점에서 한계도 있다. AI가 잘못된 판단을 내렸다면 그 판단을 다시 검토하는 과정에서도 같은 실수를 반복할 수 있으며, 의도적으로 행동을 숨기는 AI를 감시하기에도 아직 충분하지 않다는 설명이다.
또 감시 과정에서 대화 내용을 분석하기 때문에 개인정보 보호 문제도 남아 있다. 앤트로픽은 기존 데이터 처리 정책에 따라 보관할 수 있는 대화에만 이 기술을 적용하며, 데이터를 보관하지 않는 별도 계약이 적용된 이용량에는 사용하지 않는다고 밝혔다.
이번 연구는 AI의 능력이 높아지는 만큼 감시 기술도 함께 발전해야 한다는 문제의식에서 출발했다. 기존에는 강력한 AI 모델의 행동을 별도의 감시 모델로 확인하는 방식이 일반적이었지만, 앤트로픽은 모델 자신의 판단 능력을 활용해 대규모 이용량을 낮은 비용으로 감시하는 가능성을 보여줬다.
다만 AI가 자신의 행동까지 신뢰성 있게 평가할 수 있는 단계에는 아직 도달하지 못했다고 인정했다.
임대준 기자 ydj@aitimes.com
